A continuación mostrare varios ejemplos para el manejo de AGRUPACIONES & ACUMULACIONES usando diferentes sentencias SQL (algunas no muy conocidas). El ejemplo fue desarrollado utilizando:
- Plataforma Windows XP
- Motor ORACLE 10G.
- IDE: PL-SQL Developer v8.0.
El ejemplo muestra un comparativo de diferentes casuísticas que uno puede ir obteniendo al combinar sentencias SQL como: COUNT, SUM, GROUP BY, GROUP BY ROLLUP, GROUP BY CUBE, GROUP BY GROUPING SETS, RANK, GROUPING, ORDER BY, ETC.
Los QUERYS a realizar muestran los siguientes resultados:
1. MUESTRA CONTENIDO TOTAL DE TABLA.
2. MUESTRA CONTENIDO TOTAL DE TABLA:
3. AGRUPACION DE [PRODUCTO ID] Y ACUMULACION DE: [ELEMENTOS] & [VENTAS].
4. ROLLUP: PARA OBTENER AGRUPACIONES DE: [AÑO] + [PRODUCTO ID], PARA CADA [AÑO] LA ACUMULACION DE SUS [ELEMENTOS] & [VENTAS]Y AL FINAL AGREGA UNA FILA NULL CON EL ACUMULADO EL 'TOTAL' DE [ELEMENTOS] & [VENTAS]. SE COMPLETAN CON NULL LAS COLUMNAS QUE NO SE ESTA CONVINANDO.
5. CUBE: PARA OBTENER AGRUPACIONES DE: [AÑO] & [PRODUCTO ID],PARA CADA [AÑO] LA ACUMULACION DE SUS [ELEMENTOS] & [VENTAS]. TAMBIEN, PARA CADA [PRODUCTO ID]] LA ACUMULACION DE SUS [ELEMENTOS] & [VENTAS], Y AL FINAL AGREGA UNA FILA NULL CON EL ACUMULADO EL 'TOTAL' DE [ELEMENTOS] & [VENTAS]. SE COMPLETAN CON NULL LAS COLUMNAS QUE NO SE ESTA CONVINANDO.
6. GROUPING SETS: PARA OBTENER 'VARIAS AGRUPACIONES' SIMULTANEAS DE: [D.YEAR & TIPO DE PRODUCTO ID & EMPLEADO ID], PARA OBTENER ACUMULACIONES DE 'ELEMENTOS' Y 'VENTAS'. SE COMPLETAN CON NULL LAS COLUMNAS QUE NO SE ESTA CONVINANDO.
7. GROUPING SETS: PARA OBTENER 'VARIAS AGRUPACIONES' SIMULTANEAS DE: [D.YEAR & (TIPO DE PRODUCTO ID + EMPLEADO ID)], PARA OBTENER ACUMULACIONES DE 'ELEMENTOS' Y 'VENTAS'. SE COMPLETAN CON NULL LAS COLUMNAS QUE NO SE ESTA CONVINANDO.
8. ROLLUP AND RANK(): PARA OBTENER LA COLUMNA 'RANKING' DE [VENTAS] EN BASE AL AGRUPAMIENTO DE [PRODUCT ID] PARA OBTENER LA ACUMULACION DE: [ELEMENTOS & VENTAS].
9. ROLLUP AND RANK(): PARA OBTENER LA COLUMNA 'RANKING' DE [VENTAS] EN BASE AL AGRUPAMIENTO DE [EMPLEADO ID] PARA OBTENER LA ACUMULACION DE: [ELEMENTOS & VENTAS].
10. GROUPING: PARA OBTENER LA COLUMNA 'RANKING' DE [VENTAS] EN BASE AL AGRUPAMIENTO DE [AÑO] PARA OBTENER LA ACUMULACION DE: [MESES & ELEMENTOS & VENTAS]. AGREGA UNA COLUMNA ADICIONAL DONDE SE VALIDA LA EXISTENCIA DE NULL, EN BASE A LA FILA CON NULL:
- GROUPING = 0 [SI ES 'NULL'].
- GROUPING = 1 [SI NO ES 'NULL'].
Para un mayor detalle de los comando SQL utilizados, descargar el TUTORIAL pulsando Aquí

domingo, 2 de enero de 2011

EVALUANDO PERFORMANCE ENTRE SENTENCIAS: FOR & FORALL
En esta oportunidad mostrare como evaluar la performance de una sentencia repetitiva muy utilizada que es FOR ante otra no muy conocida que es FORALL.
Los pasos a realizar son los siguientes:
I.- CREAR TABLAS:
II.- CREAR PROCEDURE:
III.- EJECUTAR PROCEDURE:
IV.- VERIFICAR RESULTADO OBTENIDO [CONSOLA]:
Finalmente, el resultado obtenido será el siguiente:
EVALUACION DE PERFORMANCE [TIEMPO]
----------------------------------
- REGISTRO USANDO [FOR LOOP]: 0.62 [SEG].
- REGISTRO USANDO [FORALL]: 0.03 [SEG].
La evaluación será en base a un PROCEDURE que realizara un INSERT simple en dos tablas ( Una en base a la iteración con el FOR y la otra con el FOR ALL ). Para la ejecución de dicho PROCEDURE se utilizara un DECLARE que solicitara la iteración para el registro de 20000 datos.
Para un mayor detalle de los comando SQL utilizados, descargar el TUTORIAL pulsando Aquí
sábado, 6 de noviembre de 2010
MANEJO DE CONJUNTOS EN ‘SQL’
Muchas veces al aplicar nuestros Querys en SQL en realidad no sabemos en si lo que aplicamos al hacerlos, esta vez mostrare las diferentes formas del manejo de la lógica matemática de CONJUNTOS pero aplicada al entorno de BD.
Para comenzar configuraremos el ambiente de trabajo.
- Oracle 10g Express Edition
- PL-SQL Developer v8.0
PASOS:
I- CREACIÓN TABLAS:
CREATE TABLE TB_DEMO_A( ID NUMBER, DESCRIPCION VARCHAR2( 10 ) );
CREATE TABLE TB_DEMO_B( ID NUMBER, DESCRIPCION VARCHAR2( 10 ) );
II- CREACIÓN INSERTS:
INSERT INTO TB_DEMO_A VALUES( 1, 'PRIMERO' );
INSERT INTO TB_DEMO_A VALUES( 2, 'SEGUNDO' );
INSERT INTO TB_DEMO_A VALUES( 3, 'TERCERO' );
INSERT INTO TB_DEMO_A VALUES( 4, 'CUARTO' );
INSERT INTO TB_DEMO_B VALUES( 1, 'PRIMERO' );
INSERT INTO TB_DEMO_B VALUES( 2, 'SEGUNDO' );
INSERT INTO TB_DEMO_B VALUES( 5, 'QUINTO' );
INSERT INTO TB_DEMO_B VALUES( 6, 'SEXTO' );
III- SELECTS:
SELECT a.* FROM TB_DEMO_A a;
SELECT b.* FROM TB_DEMO_B b;
IV.- AMARRES X CASO:
4.1.- "CONJUNTO A" INTERSECCION "CONJUNTO B":
4.1.1.- FORMA #1:
SELECT a.*, b.*
FROM TB_DEMO_A a,
TB_DEMO_B b
WHERE a.ID = b.ID;
4.1.1.- FORMA #2:
SELECT a.*, b.*
FROM TB_DEMO_A a
INNER JOIN TB_DEMO_B b
ON a.ID = b.ID;
4.2.- ("CONJUNTO A" INTERSECCION "CONJUNTO B") + ( "CONJUNTO A" MENOS CONJUNTO B" ):
4.2.1.- FORMA #1:
SELECT a.*, b.*
FROM TB_DEMO_A a,
TB_DEMO_B b
WHERE a.ID = b.ID(+);
4.2.2.- FORMA #2:
SELECT a.*, b.*
FROM TB_DEMO_A a
LEFT JOIN TB_DEMO_B b
ON a.ID = b.ID;
4.3.- ("CONJUNTO A" INTERSECCION "CONJUNTO B") + ( "CONJUNTO B" MENOS CONJUNTO A" ):
4.3.1.- FORMA #1:
SELECT a.*, b.*
FROM TB_DEMO_A a,
TB_DEMO_B b
WHERE a.ID(+) = b.ID;
4.3.2.- FORMA #2:
SELECT a.*, b.*
FROM TB_DEMO_A a
RIGHT JOIN TB_DEMO_B b
ON a.ID = b.ID;
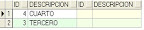
4.4.- ( "CONJUNTO A" MENOS CONJUNTO B" ):
4.4.1.- FORMA #1:
SELECT a.*, b.*
FROM TB_DEMO_A a,
TB_DEMO_B b
WHERE a.ID = b.ID(+) AND
b.ID IS NULL;
4.4.2.- FORMA #2:
SELECT a.*, b.*
FROM TB_DEMO_A a
LEFT JOIN TB_DEMO_B b
ON a.ID = b.ID
WHERE b.ID IS NULL;
4.4.3.- FORMA #3:
SELECT a.*
FROM TB_DEMO_A a
WHERE a.ID
NOT IN ( SELECT b.ID
FROM TB_DEMO_B b
);
4.4.4.- FORMA #4:
SELECT a.*
FROM TB_DEMO_A a
WHERE NOT EXISTS( SELECT b.ID
FROM TB_DEMO_B b
WHERE a.ID = b.ID
);
4.5.- ( "CONJUNTO B" MENOS CONJUNTO A" ):
4.5.1.- FORMA #1:
SELECT a.*, b.*
FROM TB_DEMO_A a,
TB_DEMO_B b
WHERE a.ID(+) = b.ID AND
a.ID IS NULL;
4.5.2.- FORMA #2:
SELECT a.*, b.*
FROM TB_DEMO_A a
LEFT JOIN TB_DEMO_B b
ON a.ID = b.ID
WHERE a.ID IS NULL;
4.5.3.- FORMA #3:
SELECT b.*
FROM TB_DEMO_B b
WHERE b.ID
NOT IN ( SELECT a.ID
FROM TB_DEMO_A a
);
4.5.4.- FORMA #4:
SELECT b.*
FROM TB_DEMO_B b
WHERE NOT EXISTS( SELECT a.ID
FROM TB_DEMO_A a
WHERE b.ID = a.ID
);
4.6.- ( "CONJUNTO A" MÁS CONJUNTO B" ) Ó ( "CONJUNTO B" MÁS CONJUNTO A" ): (NO REPETIDOS)
4.6.1.- FORMA #1:
SELECT a.ID, a.DESCRIPCION
FROM TB_DEMO_A a
UNION
SELECT b.ID, b.DESCRIPCION
FROM TB_DEMO_B b;
4.7.- ( "CONJUNTO A" MÁS CONJUNTO B" ) Ó ( "CONJUNTO B" MÁS CONJUNTO A" ):(CON REPETIDOS)
4.7.1.- FORMA #1:
SELECT a.ID, a.DESCRIPCION
FROM TB_DEMO_A a
UNION ALL
SELECT b.ID, b.DESCRIPCION
FROM TB_DEMO_B b;
Para comenzar configuraremos el ambiente de trabajo.
- Oracle 10g Express Edition
- PL-SQL Developer v8.0
PASOS:
I- CREACIÓN TABLAS:
CREATE TABLE TB_DEMO_A( ID NUMBER, DESCRIPCION VARCHAR2( 10 ) );
CREATE TABLE TB_DEMO_B( ID NUMBER, DESCRIPCION VARCHAR2( 10 ) );
II- CREACIÓN INSERTS:
INSERT INTO TB_DEMO_A VALUES( 1, 'PRIMERO' );
INSERT INTO TB_DEMO_A VALUES( 2, 'SEGUNDO' );
INSERT INTO TB_DEMO_A VALUES( 3, 'TERCERO' );
INSERT INTO TB_DEMO_A VALUES( 4, 'CUARTO' );
INSERT INTO TB_DEMO_B VALUES( 1, 'PRIMERO' );
INSERT INTO TB_DEMO_B VALUES( 2, 'SEGUNDO' );
INSERT INTO TB_DEMO_B VALUES( 5, 'QUINTO' );
INSERT INTO TB_DEMO_B VALUES( 6, 'SEXTO' );
III- SELECTS:
SELECT a.* FROM TB_DEMO_A a;
SELECT b.* FROM TB_DEMO_B b;
IV.- AMARRES X CASO:
4.1.- "CONJUNTO A" INTERSECCION "CONJUNTO B":
4.1.1.- FORMA #1:
SELECT a.*, b.*
FROM TB_DEMO_A a,
TB_DEMO_B b
WHERE a.ID = b.ID;
4.1.1.- FORMA #2:
SELECT a.*, b.*
FROM TB_DEMO_A a
INNER JOIN TB_DEMO_B b
ON a.ID = b.ID;
 |
4.2.- ("CONJUNTO A" INTERSECCION "CONJUNTO B") + ( "CONJUNTO A" MENOS CONJUNTO B" ):
4.2.1.- FORMA #1:
SELECT a.*, b.*
FROM TB_DEMO_A a,
TB_DEMO_B b
WHERE a.ID = b.ID(+);
4.2.2.- FORMA #2:
SELECT a.*, b.*
FROM TB_DEMO_A a
LEFT JOIN TB_DEMO_B b
ON a.ID = b.ID;
 |
4.3.- ("CONJUNTO A" INTERSECCION "CONJUNTO B") + ( "CONJUNTO B" MENOS CONJUNTO A" ):
4.3.1.- FORMA #1:
SELECT a.*, b.*
FROM TB_DEMO_A a,
TB_DEMO_B b
WHERE a.ID(+) = b.ID;
4.3.2.- FORMA #2:
SELECT a.*, b.*
FROM TB_DEMO_A a
RIGHT JOIN TB_DEMO_B b
ON a.ID = b.ID;
 |
4.4.- ( "CONJUNTO A" MENOS CONJUNTO B" ):
4.4.1.- FORMA #1:
SELECT a.*, b.*
FROM TB_DEMO_A a,
TB_DEMO_B b
WHERE a.ID = b.ID(+) AND
b.ID IS NULL;
4.4.2.- FORMA #2:
SELECT a.*, b.*
FROM TB_DEMO_A a
LEFT JOIN TB_DEMO_B b
ON a.ID = b.ID
WHERE b.ID IS NULL;
4.4.3.- FORMA #3:
SELECT a.*
FROM TB_DEMO_A a
WHERE a.ID
NOT IN ( SELECT b.ID
FROM TB_DEMO_B b
);
4.4.4.- FORMA #4:
SELECT a.*
FROM TB_DEMO_A a
WHERE NOT EXISTS( SELECT b.ID
FROM TB_DEMO_B b
WHERE a.ID = b.ID
);
 |
4.5.- ( "CONJUNTO B" MENOS CONJUNTO A" ):
4.5.1.- FORMA #1:
SELECT a.*, b.*
FROM TB_DEMO_A a,
TB_DEMO_B b
WHERE a.ID(+) = b.ID AND
a.ID IS NULL;
4.5.2.- FORMA #2:
SELECT a.*, b.*
FROM TB_DEMO_A a
LEFT JOIN TB_DEMO_B b
ON a.ID = b.ID
WHERE a.ID IS NULL;
4.5.3.- FORMA #3:
SELECT b.*
FROM TB_DEMO_B b
WHERE b.ID
NOT IN ( SELECT a.ID
FROM TB_DEMO_A a
);
4.5.4.- FORMA #4:
SELECT b.*
FROM TB_DEMO_B b
WHERE NOT EXISTS( SELECT a.ID
FROM TB_DEMO_A a
WHERE b.ID = a.ID
);
 |
4.6.- ( "CONJUNTO A" MÁS CONJUNTO B" ) Ó ( "CONJUNTO B" MÁS CONJUNTO A" ): (NO REPETIDOS)
4.6.1.- FORMA #1:
SELECT a.ID, a.DESCRIPCION
FROM TB_DEMO_A a
UNION
SELECT b.ID, b.DESCRIPCION
FROM TB_DEMO_B b;
 |
4.7.- ( "CONJUNTO A" MÁS CONJUNTO B" ) Ó ( "CONJUNTO B" MÁS CONJUNTO A" ):(CON REPETIDOS)
4.7.1.- FORMA #1:
SELECT a.ID, a.DESCRIPCION
FROM TB_DEMO_A a
UNION ALL
SELECT b.ID, b.DESCRIPCION
FROM TB_DEMO_B b;
 |
jueves, 4 de noviembre de 2010
BIENVENIDA 'BLOG - SQL'
Bienvenida amigos, desde hoy activo este BLOGs que he creado de modo exclusivo para mostrar TIPs y Temas importantes muchas veces así nomás no tocados a detalle en el manejo de diferentes "Motores de Datos" juntos con sus lenguajes de Programación de cada uno:
- ORACLE = PL/SQL
- MYSQL = MYSQL
- SQLSERVER = TRANSACT SQL
- POSTGRES = PGSQL
Muy pronto comenzare con los POST, ya que desde ya estoy ordenando los temas a postear esperando poder apoyarlos en sus desarrollos de alguna manera.
Nos vemos.
- ORACLE = PL/SQL
- MYSQL = MYSQL
- SQLSERVER = TRANSACT SQL
- POSTGRES = PGSQL
Muy pronto comenzare con los POST, ya que desde ya estoy ordenando los temas a postear esperando poder apoyarlos en sus desarrollos de alguna manera.
Nos vemos.
Suscribirse a:
Entradas (Atom)